Kurzfassung. nginx hat am 18. November Fixes für nginx2root (CVE-2026-123007 und vier verwandte RCEs) veröffentlicht. PHP hat am 19. November Fixes für 17 CVEs veröffentlicht, sieben davon kritisch. Am Abend des 20. haben wir unseren eigenen Produktionsserver gepatcht.
- 43 Container in wenigen Minuten geprüft, indem wir jeden einzelnen gefragt haben, welches nginx und welches PHP er laufen hat.
- 13 liefen mit einer alten Version. Nur 6 waren exponiert: die PHP-Container von drei öffentlichen Web-Apps.
- Jeder Fix kam aus einem offiziellen Image, das wir vor dem Download in der Registry verifiziert haben.
- Das riskanteste Upgrade (ein Sprung über 8 Releases bei ERPNext) haben wir zuerst auf einem Fork mit echten Daten durchgespielt. Der Fork hat die eine Frage beantwortet, die die Release Notes nicht beantworten konnten.
- Eine Platte ist mitten im Download vollgelaufen. Das Volume online zu vergrößern hat 3,9 Sekunden gedauert, ohne Downtime.
Was veröffentlicht wurde
nginx2root ist eine Sammlung von fünf Remote-Code-Execution-Bugs im Open-Source-nginx. Der prominenteste, CVE-2026-123007, ist ein Integer Underflow in der HTTP/2-Flow-Control und hat nach CVSS 4.0 einen Score von 9.2. Er betrifft jedes nginx von 1.9.5 (2015) bis 1.31.8, bei dem HTTP/2 aktiviert ist. Die anderen vier brauchen HTTP/3 hinter einem Proxy, den Mail-Proxy mit auth_http oder den DNS-Resolver in Kombination mit mirror. Gefixte Releases: 1.31.9 (Mainline) und 1.30.7 (Stable). Noch am selben Tag tauchte ein öffentlicher Proof of Concept auf.
Das PHP-Release kam einen Tag später: 8.5.13, 8.4.28, 8.3.37 und 8.2.36. Die schlimmsten Bugs stecken in der Session-Verarbeitung und im Timezone-Cache und können in Codeausführung enden. Eine zweite Gruppe betrifft nur PHP-FPM: Request Smuggling, ein XSS auf der Status-Seite und eine lokale Privilege Escalation.
Der Server in dieser Geschichte heißt hostinger, es ist dieselbe Produktionsmaschine wie in unserem PocketOS-Test. Darauf laufen ein Mailserver mit Webmail, Nextcloud, ein Marketing-Stack, ERPNext, ein GitLab, ein Observability-Stack und ein paar Demos. Jede App lebt in ihrem eigenen Rediacc-Repository: ein verschlüsseltes Volume mit eigenem Docker-Daemon und eigenem privatem IP-Bereich.
Schritt 1: Erst herausfinden, was verwundbar ist, dann, was exponiert ist
Image-Tags lügen durch Weglassen. nextcloud:35-apache sagt nichts über das PHP darin, und ein Debian-Paket meldet vor und nach einem Security-Fix weiterhin nginx/1.26.3. Statt Tags zu lesen, haben wir deshalb jeden laufenden Container direkt gefragt.
for repo in nextcloud mail mautic erpnext gitlab marketing observability demo-stackoverflow; do
  rdc term connect "$repo@hostinger" -c 'for c in $(docker ps --format "{{.Names}}"); do
    echo "$c: $(docker exec "$c" sh -c "nginx -v 2>&1; php -v 2>/dev/null | head -1")"
  done'
done
rdc term connect <repo> öffnet eine Shell in der eigenen Umgebung des Repositorys, wobei DOCKER_HOST schon auf den Docker-Daemon dieses Repositorys zeigt. Eine einzige Schleife deckte die ganze Maschine ab.
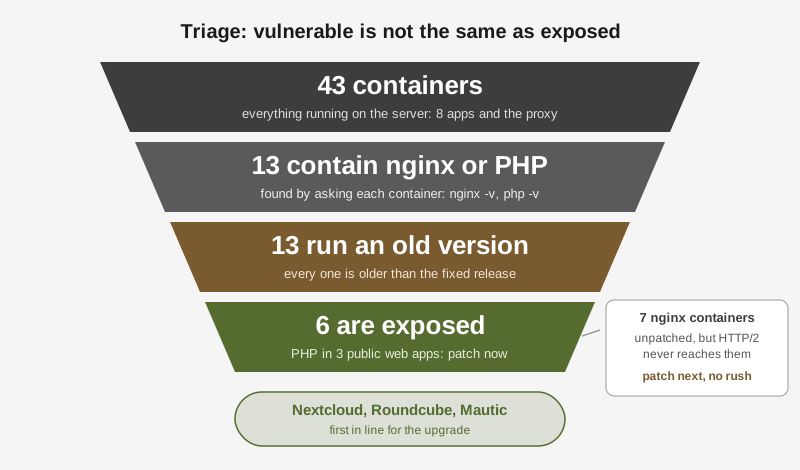
Das Ergebnis: 13 Container enthielten nginx oder PHP, und alle 13 waren älter als der Fix. Das klingt nach 13 Notfällen. Waren es aber nicht.
Verwundbar heißt, dass der Code den Bug hat. Exponiert heißt, dass ein Angreifer den Bug tatsächlich erreichen kann. Der Unterschied liegt im Netzwerkpfad, und auf diesem Server nimmt jeder öffentliche Request denselben Weg.
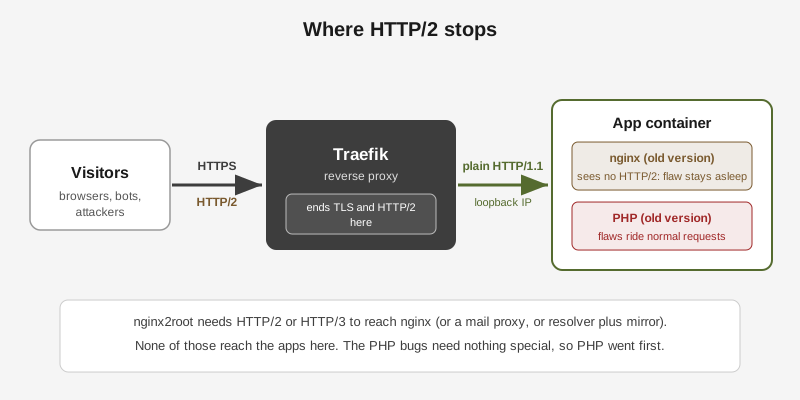
Traefik, der Reverse Proxy vor jedem Repository, terminiert TLS und HTTP/2. Mit jeder App spricht er über einfaches HTTP/1.1 auf einer privaten Loopback-Adresse. Wir haben die nginx-Configs in den beiden Apps geprüft, die nginx mitbringen: kein http2, kein HTTP/3, kein mirror, kein Mail-Proxy. nginx2root hatte also keinen Weg hinein.
Bei den PHP-Bugs ist das anders. Sie reisen in ganz normalen Web-Requests mit. Nextcloud, Roundcube (das Webmail) und Mautic liefen alle mit PHP hinter Apache, hingen alle am Internet und waren alle ein Patch-Release im Rückstand. Diese sechs Container kamen ganz nach vorn.
Ein Detail machte das PHP-Bild etwas besser: Alle drei Apps betreiben PHP als Apache-Modul und nicht als PHP-FPM, die reinen FPM-Bugs trafen also nicht zu. Die Session- und Timezone-Bugs dagegen schon.
Schritt 2: Den offiziellen Fix finden und der Registry mehr trauen als Blogposts
Unsere ersten Websuchen lieferten selbstsichere, widersprüchliche Antworten. Ein Artikel sagte, das offizielle Nextcloud-Image enthalte noch ein altes PHP. Ein anderer sagte, ein Image eines Drittanbieters habe den Fix. Keiner zitierte das Image selbst.
Um zu sehen, was in einem Image steckt, muss man es nicht herunterladen. Die Registry liefert die Config jedes Images aus, und die offiziellen PHP-basierten Images tragen dort PHP_VERSION ein.
curl -s "https://registry-1.docker.io/v2/library/nextcloud/blobs/<config-digest>" \
  -H "Authorization: Bearer $TOKEN" | jq -r '.config.Env[]' | grep PHP_VERSION
# PHP_VERSION=8.5.13
So hatten wir für jede App innerhalb von Minuten eine klare Antwort:
| App | Läuft | Offizieller Fix | PHP im Fix |
|---|---|---|---|
| Nextcloud | 35.0.2 | nextcloud:35.0.3-apache | 8.5.13 |
| Roundcube | 1.7.5 | roundcube/roundcubemail:1.7.6-apache | 8.4.28 |
| Mautic | 7.2.1 | mautic/mautic:7.2.2-20261119-apache | 8.3.37 |
| ERPNext | v16.52.1 | frappe/erpnext:v16.60.0 | (nginx: unbekannt) |
ERPNext war der Sonderfall. Sein nginx kommt aus dem Debian-Paket, die Versionsangabe bleibt also in beiden Fällen bei 1.26.3. Der gefixte Debian-Build ist 1.26.3-3+deb13u11 und erschien am 19. November. Das neue ERPNext-Image wurde an dem Abend gebaut. War der Fix darin? Die Image-Config kann das nicht sagen. Das kann nur ein Start des Images.
Schritt 3: Das riskante Update auf einem Fork durchspielen
Patch-Releases wie Roundcube 1.7.5 auf 1.7.6 sind risikoarm. ERPNext v16.52 auf v16.60 sind dagegen acht Releases voller Datenbankmigrationen auf echten Buchhaltungsdaten. Dieses Update bekam eine Probe.
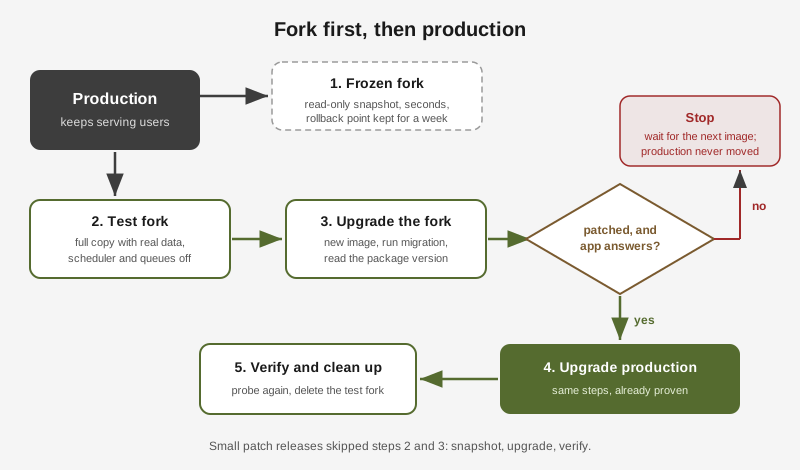
Ein Rediacc-Fork ist eine vollständige Kopie eines Repositorys inklusive Daten, erstellt als Copy-on-Write-Clone. Das dauert unabhängig von der Größe nur Sekunden, und die Kopie bekommt einen eigenen Docker-Daemon, einen eigenen IP-Bereich und eine eigene URL. Nichts darin kann Produktion berühren.
rdc repo fork erpnext@hostinger --tag cve-test
rdc repo up erpnext:cve-test@hostinger --no-start   # mount only, start nothing yet
Bevor wir den Fork gestartet haben, haben wir seine Compose-Datei angepasst: den neuen Image-Tag eingetragen und den Scheduler sowie beide Job-Queues unter ein deaktiviertes Profile gelegt. Eine Kopie echter ERPNext-Daten mit laufendem Scheduler würde echte E-Mails an echte Kunden schicken. Mit abgeschalteten Komponenten konnte der Fork Seiten ausliefern und Migrationen ausführen, mehr nicht.
docker run --rm --entrypoint dpkg-query frappe/erpnext:v16.60.0 -W nginx
# nginx  1.26.3-3+deb13u11
Da war die Antwort: Das neue Image brachte Debians gepatchtes nginx mit. Danach hat der Fork das komplette Upgrade durchlaufen: bench --site all migrate lief auf einer Kopie der Produktionsdatenbank sauber durch, die App antwortete am Health-Endpoint mit pong, und die Login-Seite lud unter der eigenen URL des Forks.
Hätte das Image noch das alte Paket enthalten, wäre der Plan einfach gewesen: stoppen, den Fork löschen und auf den nächsten Build warten. Produktion wäre unberührt geblieben, statt für ein Upgrade neu zu starten, das nichts behebt.
Schritt 4: Produktion, eine App nach der anderen
Jede App durchlief dieselbe kurze Routine:
- Snapshot.
rdc repo fork <app> --tag pre-cve-20261120 --immutableerzeugt eine eingefrorene, schreibgeschützte Kopie. Sie lässt sich weder mounten noch starten, also kann sie sich nie mehr ändern. - Tag pinnen. Die Compose-Datei auf den exakten gefixten Tag setzen.
- Pull, dann Deploy.
docker pull, dannrdc repo up <app> -y. - Den eigenen Upgrade-Schritt der App ausführen, wo es einen gibt.
- Verifizieren von innen (Version, Migrationen) und von außen (die öffentliche URL).
| App | Was passiert ist | Container wieder oben |
|---|---|---|
| Nextcloud | Der Image-Entrypoint führte occ upgrade 35.0.2 auf 35.0.3 aus, etwa eine Minute im Wartungsmodus | 66 s |
| Roundcube | Einfacher Image-Tausch, der Schema-Check fand nichts zu tun | 24 s |
| Mautic | Platte beim ersten Pull voll (siehe unten), danach doctrine:migrations:migrate | 6 s |
| ERPNext | Dieselben Schritte wie bei der Probe, Scheduler blieb an, bench migrate mit Exit-Code 0 | 17 s |
Die abschließende Prüfung zeigte PHP 8.5.13, 8.4.28 und 8.3.37 in jedem PHP-Container, nginx deb13u11 in ERPNext und alle 43 Container laufend, ohne fehlschlagenden Health-Check.
Was schiefgelaufen ist
Ein Floating Tag hat ein veraltetes Image versteckt. Nextcloud lief auf nextcloud:35-apache. Dieser Tag zeigte schon auf das gefixte Image, aber docker compose up -d zieht kein Image, das schon lokal vorhanden ist, der Server hätte also für immer das alte PHP behalten. Wer 35.0.3-apache pinnt, sieht die laufende Version in der Compose-Datei und erzwingt bei jedem Upgrade eine echte Änderung.
Eine Platte ist mitten im Download vollgelaufen. Das Mautic-Image ist 2,1 GB groß, und im Repository waren 1,4 GB frei. Der Pull scheiterte mit no space left on device, bevor er die laufenden Container berührt hat. Die Lösung war ein einziger Befehl, ausgeführt, während Mautic weiter Traffic bediente:
rdc repo expand mautic@hostinger --size 12G
# Repository expanded (3.9s)
Das Volume wuchs online von 8 GB auf 12 GB, und der Pull lief durch. Die Size-Policy der Maschine kann ein Repository jetzt automatisch vergrößern, bevor es vollläuft.
Die eingefrorenen Snapshots wurden nie gebraucht. Jedes Upgrade hat funktioniert, die vier pre-cve-Kopien lagen also nur herum. Das ist der Sinn eines Sicherheitsnetzes, aber zwei ehrliche Anmerkungen. Sie wurden bei laufenden Apps erstellt, die Datenbankdateien darin sind also crash-konsistent, genau wie nach einem Stromausfall, und kein sauberer Shutdown. Und ein Rollback, den noch nie jemand geprobt hat, ist ein Plan und keine Garantie. Beim nächsten Mal testen wir einen Restore, solange der Snapshot noch frisch ist.
Eine App hat noch kein gefixtes Release. Eine zweite App bringt ihr eigenes nginx im Image des Herstellers mit, und dieser Hersteller hat nginx 1.31.9 noch nicht ausgeliefert. Der oben beschriebene Traffic-Pfad hält HTTP/2 von ihr fern, also warten wir auf das Release des Herstellers, statt ein selbstgebautes Image einzusetzen.
Die Entscheidungen und warum
| Option, die wir hatten | Was wir gewählt haben | Warum |
|---|---|---|
| HTTP/2 als schnelle Mitigation abschalten | Mit neuen Images patchen | HTTP/2 endete schon bei Traefik, die Mitigation hätte also nichts gebracht. Patchen beseitigt den Bug, statt ihn zu verstecken. |
| Der Versionsangabe trauen | Das Paket im Image prüfen | Debian portiert Fixes zurück, ohne nginx -v zu ändern. Nur dpkg-query zeigt den echten Build. |
| Artikeln glauben, welches Image gefixt ist | Die Image-Config in der Registry lesen | Die Artikel waren sich uneinig. Die Registry ist die Quelle. |
Floating Tags wie 35-apache | Exakte Tags wie 35.0.3-apache | Ein Floating Tag kann auf den Fix zeigen, während der Server weiter das alte Image betreibt. |
| In place upgraden, bei Problemen zurückrollen | Bei großen Sprüngen zuerst Fork, bei kleinen zuerst Snapshot | Eine Fork-Probe kostet Sekunden und findet das Problem, bevor es die Nutzer tun. Eine volle Probe für ein Patch-Release mit einem Schritt ist übertrieben. |
Traffic mit einem Canary aufteilen (rdc repo canary) | Auf einem Fork proben | Ein Canary startet die neue Version auf Live-Daten, was zu Apps mit abwärtskompatiblen Schemas passt. Eine Migration über 8 Releases ist das nicht. |
| Die volle Platte von Hand aufräumen | Das Volume online vergrößern | Dateien im Docker-Datenordner zu löschen ist riskant. Vergrößern ist ein Befehl und braucht keinen Neustart. |
Die Checkliste, die wir behalten
- Jeden Container fragen, was er laufen hat. Keine Tags lesen.
- Verwundbar von exponiert trennen, indem man dem echten Netzwerkpfad folgt.
- Die exponierten heute patchen, den Rest diese Woche.
- Den Fix aus der Registry lesen, nicht aus Artikeln.
- Bei einem Paket-Fix den Paket-Build im Image prüfen.
- Vor jeder Änderung einen Snapshot machen. Auf einem Fork proben, wenn das Upgrade Daten migriert.
- Exakte Tags pinnen.
- Von innen und von außen verifizieren, dann die Forks aufräumen.
Der ganze Lauf, vom Lesen der Advisories bis zur letzten Verifikation, wurde von einem KI-Agenten (Claude Code) gesteuert, der über rdc gearbeitet hat, mit Produktionszugriff, den der Operator vor Sitzungsbeginn freigegeben hatte. Die Fork-first-Routine hat das entspannt gemacht: Der Agent hat seine Experimente auf Kopien gemacht, und Produktion hat nur Schritte gesehen, die vorher schon funktioniert hatten.