Quand AWS tombe en panne, pas vous
Votre infrastructure tourne sur plusieurs clouds. Quand l’un tombe en panne, les autres prennent le relais. Automatiquement.
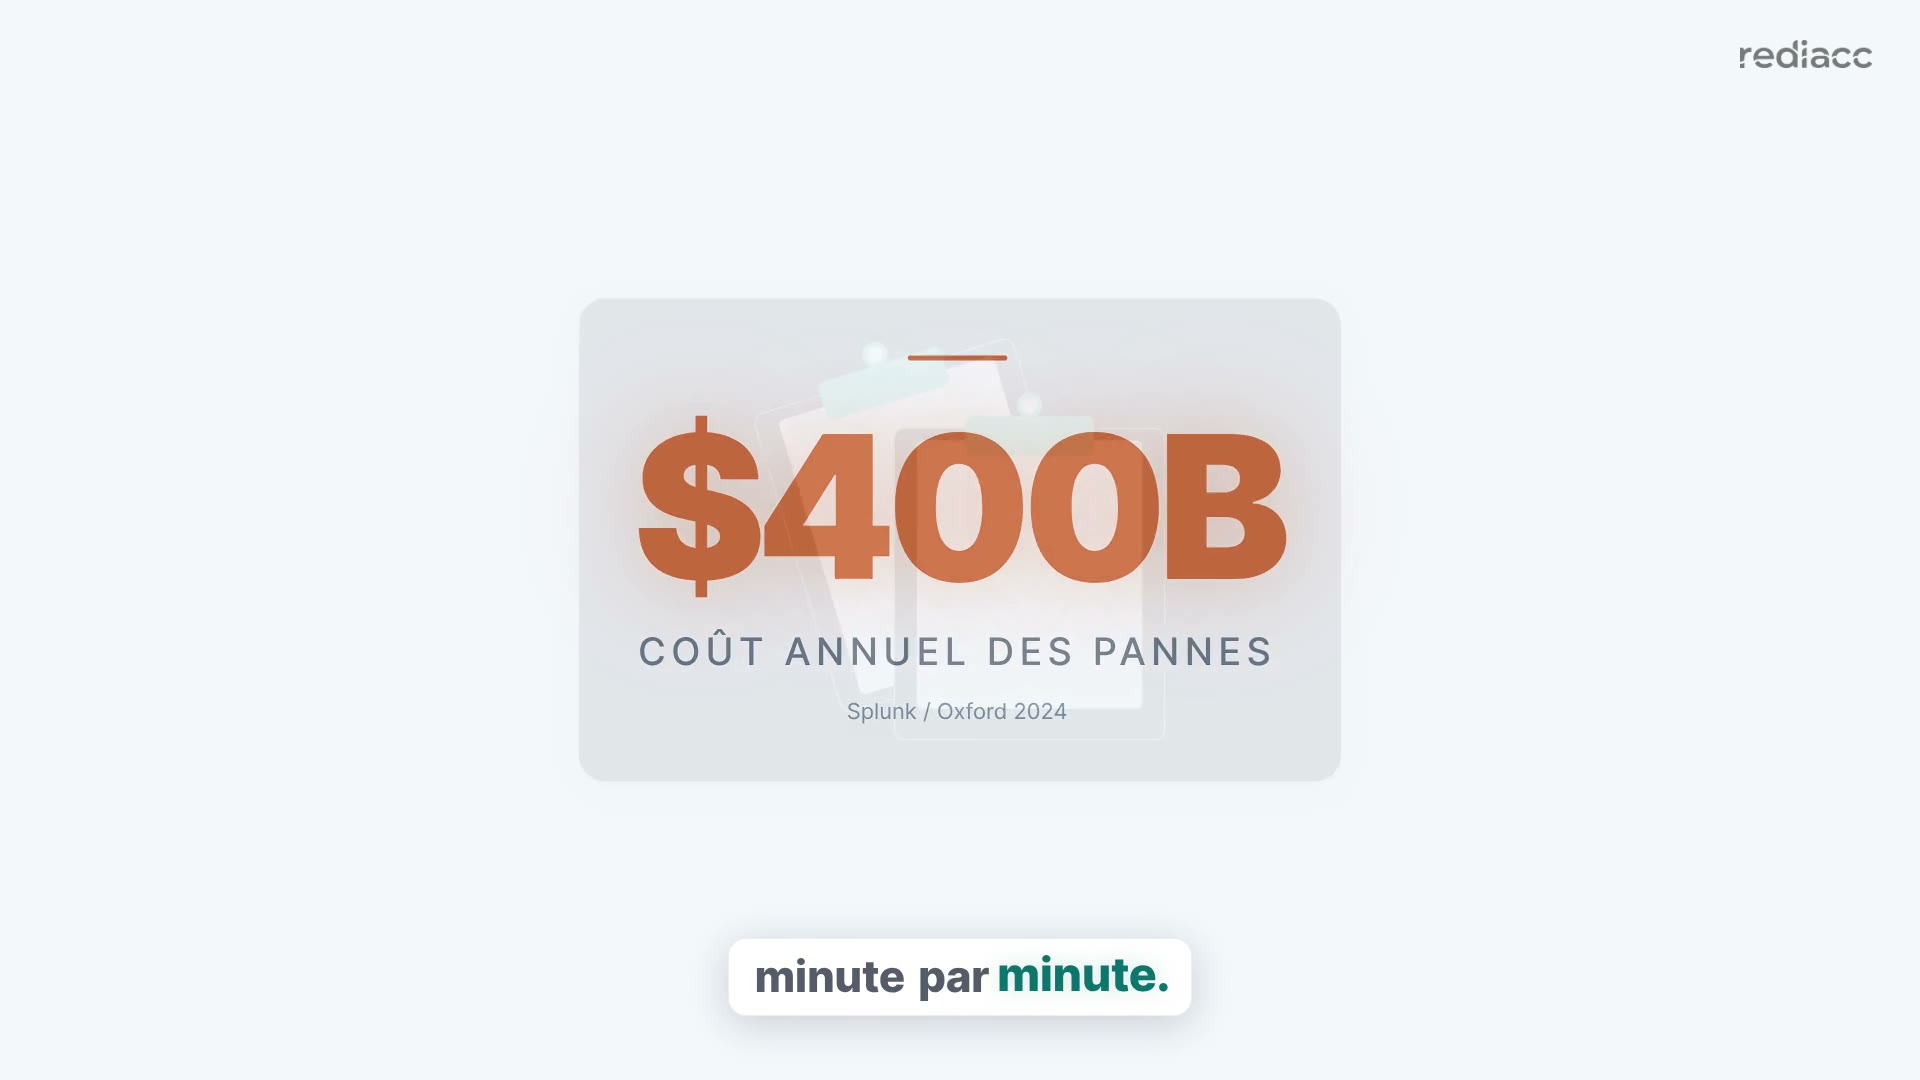
Un seul cloud est un point de défaillance unique
Les événements de panne cloud critique ont augmenté de 18 % d’une année sur l’autre en 2024, ont duré 18,7 % plus longtemps, et l’erreur humaine en a causé 68 %. Quand votre seul cloud tombe, tout tombe. Vos clients, vos revenus, votre réputation. Tout otage de l’infrastructure de quelqu’un d’autre.
Voir la chronologie
Combien coûte une panne cloud ?
Déplacez les curseurs pour correspondre à votre activité. Voyez le vrai coût de la dépendance à un seul cloud.
Une commande. Toujours en ligne.
Répliquer
Lancez une commande : rdc replicate production --target secondary. Seules les données modifiées se synchronisent, pas l'ensemble. Rapide et économe.
Surveiller
Les vérifications de santé continues détectent les pannes instantanément. Compatible avec votre pile de monitoring (Grafana, Prometheus).
Basculer
Le trafic bascule vers l'infrastructure saine en moins de 30 secondes. Mises à jour DNS automatiques. Zéro étape manuelle.
Pourquoi la réplication inter-cloud est rapide et économique
Rediacc ne copie que les données modifiées depuis la dernière fois. Prenons un environnement de 380 GB dont 2,4 GB changent aujourd'hui. Rediacc transfère 2,4 GB, pas 380 GB. Cela réduit la bande passante de 98 %. Il peut tourner en continu ou selon un planning.
Pourquoi la réplication inter-cloud est rapide et économique
| Approche traditionnelle | Rediacc (btrfs send/receive) |
|---|---|
| Transfert d'image VM complète : 380 Go par cycle de sync, des heures pour terminer | Diff incrémental : uniquement les blocs modifiés, 2,4 Go de transfert quotidien typique |
| Réplication liée au fournisseur (AWS vers AWS, Azure vers Azure) | Agnostique au cloud : n'importe quelle machine Linux vers n'importe quelle machine Linux |
| Basculement DNS manuel : 15-60 minutes de temps ingénieur | Vérification de santé automatisée + basculement DNS en moins de 30 secondes |
| Frais de sortie : 0,09 $/Go, ~34 $/sync pour 380 Go d'image complète | Frais de sortie : 0,09 $/Go, ~0,22 $/sync pour 2,4 Go de diff incrémental |
Ce que vous obtenez
Toujours en ligne
Un cloud tombe, un autre prend le relais. Aucune intervention manuelle. Le basculement automatique se déclenche sur échec de vérification de santé. Compatible avec votre pile de monitoring.
Multi-cloud par défaut
AWS, Azure, GCP, Hetzner ou votre propre matériel. Combinez à volonté. Toute machine Linux avec btrfs peut être une cible de réplication.
Pas de dépendance fournisseur
Changez de cloud quand vous voulez. Snapshots en format ouvert. Aucun agent propriétaire. btrfs standard, intégré à Linux depuis 2013.
Vous manquez de temps ?
Passez l'analyse approfondie. Téléchargez la version cinq minutes que votre équipe peut lire lors d'un stand-up.
Télécharger la note courte (PDF)Aucun autre outil ne bascule entre clouds en quelques secondes
Les outils cloud natifs répliquent au sein de leur cloud. Les outils de sauvegarde restaurent des heures plus tard. Rediacc réplique entre n’importe quel fournisseur et bascule en moins de 30 secondes.
Aucun autre outil ne bascule entre clouds en quelques secondes
| Fonctionnalité | AWS Backup | Veeam | Zerto | Druva | Rediacc |
|---|---|---|---|---|---|
| Réplication cross-cloud | ✗ | ✓ | ✓ | ✗ | ✓ |
| Basculement en moins de 30 secondes | ✗ | ✗ | ✗ | ✗ | ✓ |
| Transfert incrémental uniquement (98 % d'économies) | ✗ | ✓ | ✓ | ✗ | ✓ |
| Basculement de tout fournisseur vers tout fournisseur | ✗ | ✗ | ✗ | ✗ | ✓ |
| Auto-hébergé, pas d'agent cloud | ✗ | ✓ | ✗ | ✗ | ✓ |
| Basculement DNS automatique | ✗ | ✗ | ✓ | ✗ | ✓ |
| Réplication de la pile complète (app + BDD) | ✗ | ✓ | ✓ | ✗ | ✓ |
Références (14)
- ITIC, “2024 Hourly Cost of Downtime Report,” 2024. “Le coût moyen d'une heure de panne dépasse désormais 300 000 $ pour plus de 90 % des PME et grandes entreprises.”
- Parametrix, “2024 Cloud Outage Risk Report,” 2024. “Les incidents critiques d'interruption de service cloud ont augmenté de 18,0 % et ont duré 18,7 % plus longtemps en 2024 qu'en 2023. L'erreur humaine en a causé 68 %.”
- Splunk & Oxford Economics, “The Hidden Costs of Downtime,” 2024. “Le coût total des pannes pour le Global 2000 est de 400 G$ annuellement, soit 9 % des profits, lorsque l'infrastructure numérique défaille inopinément.”
- Veeam prend en charge la sauvegarde et la réplication multi-cloud entre VMware, Hyper-V, AWS, Azure et Google Cloud.
- Zerto réplique les charges de travail entre VMware, Hyper-V, AWS, Azure, IBM Cloud et 350+ fournisseurs de services cloud.
- Druva offre la reprise après sinistre multi-cloud en stockant les données de sauvegarde sur AWS et Azure depuis une seule console.
- Veeam utilise la sauvegarde incrémentale avec le suivi des blocs modifiés (CBT) pour ne transférer que les blocs de données modifiés.
- Les VRA Zerto répliquent continuellement uniquement les blocs de données modifiés au niveau de l'hyperviseur de façon quasi-synchrone.
- Druva utilise la sauvegarde incrémentale permanente avec déduplication de blocs variables mondiale, économisant jusqu'à 90 % de la bande passante.
- Veeam Backup & Replication est déployé sur site sur Windows Server avec contrôle complet du client sur l'infrastructure.
- Zerto est déployé sur site avec un Zerto Virtual Manager et des appliances de réplication virtuelle par hôte.
- Zerto offre le réadressage IP automatisé des VM récupérées lors du basculement avec des scripts de pré/post-récupération pour les mises à jour DNS.
- Veeam Backup & Replication offre la réplication continue de piles d'applications complètes avec basculement orchestré.
- Les groupes de protection virtuelle Zerto répliquent les piles d'applications multi-VM comme une seule unité cohérente avec fidélité d'ordre d'écriture.
Explorer d’autres solutions
Ne pariez pas votre entreprise sur un seul cloud
Commencez avec l’édition Community gratuite. Répliquez entre sites gratuitement. Pas de carte bancaire.
Commencer gratuitement avec Community