TL;DR. Il 18 novembre nginx ha rilasciato le correzioni per nginx2root (CVE-2026-123007 e altre quattro RCE sorelle). Il 19 novembre PHP ha rilasciato le correzioni per 17 CVE, sette delle quali critiche. La sera del 20 abbiamo aggiornato il nostro server di produzione.
- 43 container controllati in pochi minuti, chiedendo a ciascuno quale versione di nginx e di PHP sta eseguendo.
- 13 giravano su una versione vecchia. Solo 6 erano esposti: i container PHP di tre web app pubbliche.
- Ogni correzione è arrivata da un’immagine ufficiale, verificata nel registry prima del download.
- L’upgrade più rischioso (un salto di 8 release di ERPNext) è stato provato prima su un fork con dati reali. Il fork ha risposto alla domanda a cui le note di rilascio non sapevano rispondere.
- Un disco si è riempito a metà download. Ampliare il volume online è costato 3,9 secondi, senza downtime.
Cosa è stato divulgato
nginx2root è un insieme di cinque bug di remote code execution in nginx open source. Il più grave, CVE-2026-123007, è un integer underflow nel controllo di flusso di HTTP/2, con punteggio 9,2 su CVSS 4.0. Riguarda ogni nginx dalla 1.9.5 (2015) alla 1.31.8 con HTTP/2 attivo. Gli altri quattro richiedono HTTP/3 dietro un proxy, il mail proxy con auth_http, oppure il resolver DNS usato insieme a mirror. Le release corrette sono 1.31.9 (mainline) e 1.30.7 (stable). Lo stesso giorno è comparsa una proof of concept pubblica.
La release di PHP è arrivata il giorno dopo: 8.5.13, 8.4.28, 8.3.37 e 8.2.36. I bug peggiori stanno nella gestione delle sessioni e nella cache dei timezone, e possono portare all’esecuzione di codice. Un secondo gruppo colpisce solo PHP-FPM: request smuggling, un XSS nella pagina di stato e una local privilege escalation.
Il server di questa storia è hostinger, la stessa macchina di produzione del nostro test PocketOS. Ospita un mail server con webmail, Nextcloud, uno stack di marketing, ERPNext, un GitLab, uno stack di osservabilità e qualche demo. Ogni app vive in un proprio repository Rediacc: un volume cifrato con il suo daemon Docker e il suo range di IP privati.
Passo 1: capire cosa è vulnerabile, poi cosa è esposto
I tag delle immagini mentono per omissione. nextcloud:35-apache non dice nulla sul PHP che c’è dentro, e un pacchetto Debian continua a riportare nginx/1.26.3 sia prima sia dopo una correzione di sicurezza. Quindi, invece di leggere i tag, abbiamo chiesto direttamente a ogni container in esecuzione.
for repo in nextcloud mail mautic erpnext gitlab marketing observability demo-stackoverflow; do
  rdc term connect "$repo@hostinger" -c 'for c in $(docker ps --format "{{.Names}}"); do
    echo "$c: $(docker exec "$c" sh -c "nginx -v 2>&1; php -v 2>/dev/null | head -1")"
  done'
done
rdc term connect <repo> apre una shell dentro l’ambiente del repository, con DOCKER_HOST già puntato al daemon Docker di quel repository. Un solo ciclo ha coperto l’intera macchina.
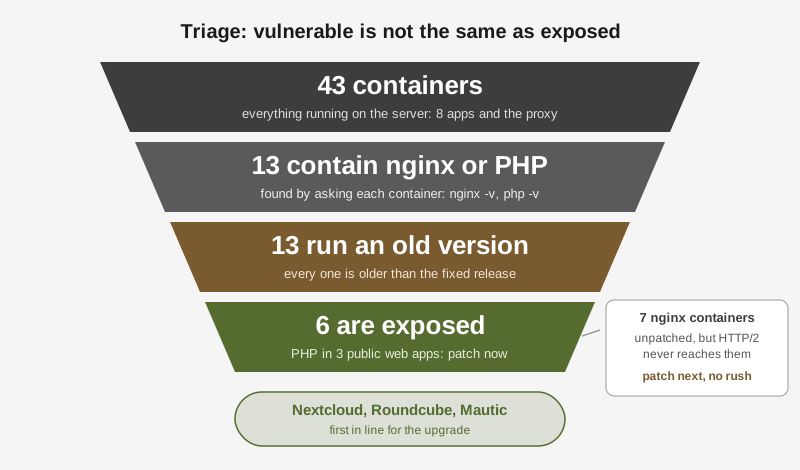
Il risultato: 13 container contenevano nginx o PHP, e tutti e 13 erano più vecchi della correzione. Sembrano 13 emergenze. Non lo erano.
Vulnerabile significa che il codice contiene il bug. Esposto significa che un attaccante può davvero raggiungerlo. La differenza sta nel percorso di rete, e su questo server ogni richiesta pubblica segue lo stesso percorso.
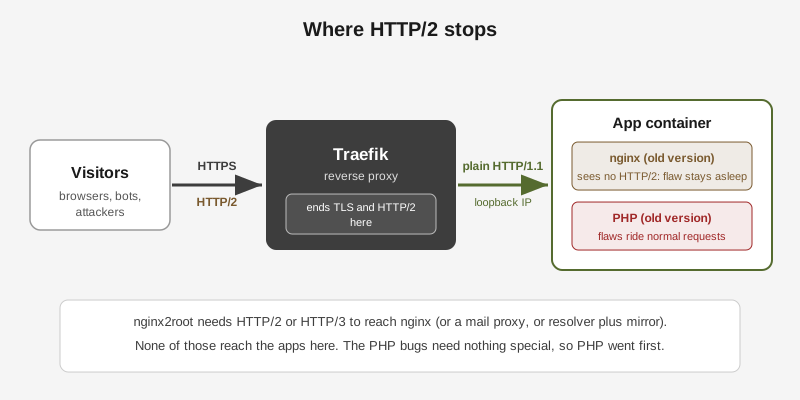
Traefik, il reverse proxy davanti a ogni repository, termina TLS e HTTP/2. Parla con ogni app in HTTP/1.1 in chiaro su un indirizzo loopback privato. Abbiamo controllato le configurazioni nginx nelle due app che includono nginx: niente http2, niente HTTP/3, niente mirror, niente mail proxy. Quindi nginx2root non aveva alcuna via d’ingresso.
I bug di PHP sono un’altra storia. Viaggiano dentro normali richieste web. Nextcloud, Roundcube (la webmail) e Mautic giravano tutti con PHP dietro Apache, erano tutti esposti a internet e tutti indietro di una patch release. Questi sei container sono passati in cima alla lista.
Un dettaglio migliorava un po’ il quadro di PHP: le tre app eseguono PHP come modulo Apache, non come PHP-FPM, quindi i bug solo FPM non si applicavano. I bug di sessione e di timezone sì.
Passo 2: trovare la correzione ufficiale, fidandosi del registry più che dei blog
Le nostre prime ricerche sul web hanno dato risposte sicure di sé e in contraddizione. Un articolo diceva che l’immagine ufficiale di Nextcloud conteneva ancora un PHP vecchio. Un altro diceva che un’immagine di terze parti aveva la correzione. Nessuno citava l’immagine stessa.
Per leggere cosa c’è dentro un’immagine non serve scaricarla. Il registry espone la config di ogni immagine, e le immagini ufficiali basate su PHP vi registrano PHP_VERSION.
curl -s "https://registry-1.docker.io/v2/library/nextcloud/blobs/<config-digest>" \
  -H "Authorization: Bearer $TOKEN" | jq -r '.config.Env[]' | grep PHP_VERSION
# PHP_VERSION=8.5.13
In pochi minuti abbiamo avuto una risposta chiara per ogni app:
| App | In esecuzione | Correzione ufficiale | PHP nella correzione |
|---|---|---|---|
| Nextcloud | 35.0.2 | nextcloud:35.0.3-apache | 8.5.13 |
| Roundcube | 1.7.5 | roundcube/roundcubemail:1.7.6-apache | 8.4.28 |
| Mautic | 7.2.1 | mautic/mautic:7.2.2-20261119-apache | 8.3.37 |
| ERPNext | v16.52.1 | frappe/erpnext:v16.60.0 | (nginx: sconosciuto) |
ERPNext era il caso anomalo. Il suo nginx arriva dal pacchetto Debian, quindi la stringa di versione resta 1.26.3 in entrambi i casi. La build corretta di Debian è 1.26.3-3+deb13u11, pubblicata il 19 novembre. La nuova immagine di ERPNext è stata costruita quella sera. La correzione era dentro? La config dell’immagine non lo dice. Solo eseguendo l’immagine si può sapere.
Passo 3: provare l’upgrade rischioso su un fork
Le patch release come Roundcube da 1.7.5 a 1.7.6 sono a basso rischio. ERPNext da v16.52 a v16.60 sono otto release di migrazioni del database su dati contabili reali. Quello ha avuto una prova generale.
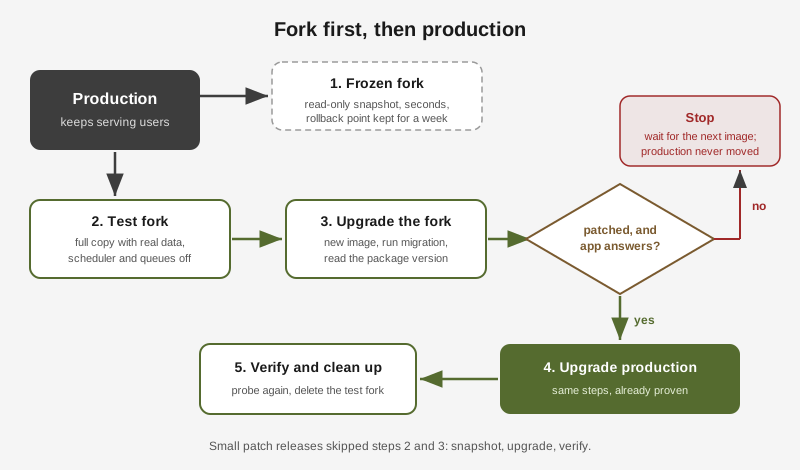
Un fork Rediacc è una copia completa di un repository, dati inclusi, fatta con un clone copy-on-write. Richiede pochi secondi qualunque sia la dimensione, e la copia ottiene il suo daemon Docker, il suo range di IP e il suo URL. Niente al suo interno può toccare la produzione.
rdc repo fork erpnext@hostinger --tag cve-test
rdc repo up erpnext:cve-test@hostinger --no-start   # mount only, start nothing yet
Prima di avviare il fork abbiamo modificato il suo file compose: il nuovo tag dell’immagine, e lo scheduler con entrambe le code di job parcheggiati sotto un profile disabilitato. Una copia di dati ERPNext reali con uno scheduler attivo manderebbe email vere a clienti veri. Con quei componenti spenti, il fork poteva servire pagine ed eseguire migrazioni, e nient’altro.
docker run --rm --entrypoint dpkg-query frappe/erpnext:v16.60.0 -W nginx
# nginx  1.26.3-3+deb13u11
Ecco la risposta: la nuova immagine portava l’nginx corretto di Debian. Poi il fork ha eseguito l’upgrade completo: bench --site all migrate è terminato senza errori su una copia del database di produzione, l’app ha risposto pong sull’endpoint di health e la pagina di login si è caricata sull’URL del fork.
Se l’immagine avesse ancora contenuto il pacchetto vecchio, il piano era semplice: fermarsi, eliminare il fork e aspettare la build successiva. La produzione sarebbe rimasta intatta, invece di riavviarsi per un upgrade che non correggeva nulla.
Passo 4: la produzione, un’app alla volta
Ogni app ha seguito la stessa breve routine:
- Snapshot.
rdc repo fork <app> --tag pre-cve-20261120 --immutablecrea una copia congelata e in sola lettura. Non può essere montata né avviata, quindi nulla potrà mai modificarla. - Pin del tag. Si modifica il file compose con l’esatto tag corretto.
- Pull, poi deploy.
docker pull, poirdc repo up <app> -y. - Eseguire il passo di upgrade dell’app stessa, dove esiste.
- Verificare da dentro (versione, migrazioni) e da fuori (l’URL pubblico).
| App | Cosa è successo | Container di nuovo attivi |
|---|---|---|
| Nextcloud | L’entrypoint dell’immagine ha eseguito occ upgrade da 35.0.2 a 35.0.3, circa un minuto in modalità manutenzione | 66 s |
| Roundcube | Semplice sostituzione dell’immagine, il controllo dello schema non ha trovato nulla da fare | 24 s |
| Mautic | Disco pieno al primo pull (vedi sotto), poi doctrine:migrations:migrate | 6 s |
| ERPNext | Stessi passi della prova generale, scheduler lasciato attivo, bench migrate con exit code 0 | 17 s |
La sonda finale ha mostrato PHP 8.5.13, 8.4.28 e 8.3.37 in ogni container PHP, nginx deb13u11 in ERPNext e tutti i 43 container in esecuzione senza nessun health check in errore.
Cosa è andato storto
Un tag mobile nascondeva un’immagine vecchia. Nextcloud usava nextcloud:35-apache. Quel tag puntava già all’immagine corretta, ma docker compose up -d non scarica un’immagine che ha già, quindi il server avrebbe tenuto il vecchio PHP per sempre. Fissare 35.0.3-apache rende visibile nel file compose la versione in esecuzione e impone un cambiamento reale a ogni upgrade.
Un disco si è riempito a metà download. L’immagine di Mautic pesa 2,1 GB e il suo repository aveva 1,4 GB liberi. Il pull è fallito con no space left on device prima di toccare i container in esecuzione. La soluzione è stata un solo comando, eseguito con Mautic ancora in servizio:
rdc repo expand mautic@hostinger --size 12G
# Repository expanded (3.9s)
Il volume è passato da 8 GB a 12 GB online e il pull è andato a buon fine. La size policy della macchina ora può far crescere un repository in automatico prima che si riempia.
Gli snapshot congelati non sono mai serviti. Ogni upgrade ha funzionato, quindi le quattro copie pre-cve sono rimaste lì. È lo scopo di una rete di sicurezza, ma con due note oneste. Sono state create con le app in esecuzione, quindi i file del database al loro interno sono crash-consistent, lo stesso stato che si avrebbe dopo un’interruzione di corrente, non uno spegnimento pulito. E un rollback mai provato è un piano, non una garanzia. La prossima volta testeremo un restore mentre lo snapshot è ancora fresco.
Un’app non ha ancora una release corretta. Una seconda app include il proprio nginx dentro l’immagine del vendor, e quel vendor non ha ancora rilasciato nginx 1.31.9. Il percorso del traffico descritto sopra tiene HTTP/2 lontano da questa app, quindi aspetta la release del vendor invece di un’immagine costruita a mano.
Le scelte, e perché
| Opzione che avevamo | Cosa abbiamo scelto | Perché |
|---|---|---|
| Disattivare HTTP/2 come mitigazione rapida | Aggiornare con nuove immagini | HTTP/2 si fermava già a Traefik, quindi la mitigazione non aggiungeva nulla. L’aggiornamento elimina il bug invece di nasconderlo. |
| Fidarsi della stringa di versione | Controllare il pacchetto dentro l’immagine | Debian fa il backport delle correzioni senza cambiare nginx -v. Solo dpkg-query mostra la build reale. |
| Fidarsi degli articoli su quale immagine è corretta | Leggere la config dell’immagine nel registry | Gli articoli erano in disaccordo. La fonte è il registry. |
Tag mobili come 35-apache | Tag esatti come 35.0.3-apache | Un tag mobile può puntare alla correzione mentre il server continua a eseguire la vecchia immagine. |
| Upgrade sul posto, rollback se si rompe | Prima un fork per i salti grandi, prima uno snapshot per quelli piccoli | La prova su un fork costa pochi secondi e trova il problema prima degli utenti. Una prova completa per una patch release di un solo passo è eccessiva. |
Dividere il traffico con un canary (rdc repo canary) | Prova generale su un fork | Un canary esegue la nuova versione su dati live, adatto ad app con schemi retrocompatibili. Una migrazione di 8 release non lo è. |
| Pulire a mano il disco pieno | Ampliare il volume online | Cancellare file nella cartella dati di Docker è rischioso. Ampliare richiede un solo comando e nessun riavvio. |
La checklist che teniamo
- Chiedere a ogni container cosa esegue. Non leggere i tag.
- Separare vulnerabile da esposto seguendo il percorso di rete reale.
- Aggiornare oggi gli esposti, il resto entro la settimana.
- Leggere la correzione dal registry, non dagli articoli.
- Per una correzione basata su pacchetto, controllare la build del pacchetto dentro l’immagine.
- Fare uno snapshot prima di ogni modifica. Provare su un fork quando l’upgrade migra dati.
- Fissare tag esatti.
- Verificare da dentro e da fuori, poi ripulire i fork.
L’intera operazione, dalla lettura degli advisory all’ultima verifica, è stata guidata da un agente IA (Claude Code) che lavorava tramite rdc, con l’accesso alla produzione concesso dall’operatore prima dell’inizio della sessione. La routine fork-first è ciò che ha reso tutto questo tranquillo: l’agente faceva i suoi esperimenti sulle copie, e la produzione vedeva solo passi che avevano già funzionato.