TL;DR. nginx a publié les correctifs de nginx2root (CVE-2026-123007 et quatre RCE voisines) le 18 novembre. PHP a corrigé 17 CVE, dont sept critiques, le 19 novembre. Dans la soirée du 20, nous avons patché notre propre serveur de production.
- 43 conteneurs vérifiés en quelques minutes, en demandant à chacun quelles versions de nginx et de PHP il exécute.
- 13 tournaient sur une ancienne version. Seuls 6 étaient exposés : les conteneurs PHP de trois applications web publiques.
- Chaque correctif venait d’une image officielle, vérifiée dans le registre avant le téléchargement.
- La mise à jour la plus risquée (un saut de 8 versions d’ERPNext) a d’abord été répétée sur un fork avec les vraies données. Le fork a répondu à la seule question que les notes de version ne réglaient pas.
- Un disque s’est rempli pendant un téléchargement. Agrandir le volume à chaud a pris 3,9 secondes, sans interruption de service.
Ce qui a été divulgué
nginx2root est un ensemble de cinq failles d’exécution de code à distance dans nginx open source. La principale, CVE-2026-123007, est un underflow d’entier dans le contrôle de flux HTTP/2, notée 9,2 en CVSS 4.0. Elle touche tous les nginx de la 1.9.5 (2015) à la 1.31.8 dont HTTP/2 est activé. Les quatre autres demandent HTTP/3 derrière un proxy, le proxy mail avec auth_http, ou le résolveur DNS utilisé avec mirror. Versions corrigées : 1.31.9 (mainline) et 1.30.7 (stable). Une preuve de concept publique est apparue le jour même.
La version de PHP est arrivée un jour plus tard : 8.5.13, 8.4.28, 8.3.37 et 8.2.36. Les pires bugs se trouvent dans la gestion des sessions et dans le cache des fuseaux horaires, et ils peuvent mener à une exécution de code. Un second groupe ne touche que PHP-FPM : du request smuggling, une XSS sur la page de statut et une élévation de privilèges locale.
Le serveur de cette histoire s’appelle hostinger, c’est la même machine de production que dans notre test PocketOS. Il héberge un serveur mail avec webmail, Nextcloud, une stack marketing, ERPNext, un GitLab, une stack d’observabilité et quelques démos. Chaque application vit dans son propre dépôt Rediacc : un volume chiffré avec son propre démon Docker et sa propre plage d’IP privées.
Étape 1 : trouver ce qui est vulnérable, puis ce qui est exposé
Les tags d’image mentent par omission. nextcloud:35-apache ne dit rien du PHP qu’il contient, et un paquet Debian continue d’afficher nginx/1.26.3 avant comme après un correctif de sécurité. Au lieu de lire les tags, nous avons donc interrogé directement chaque conteneur en cours d’exécution.
for repo in nextcloud mail mautic erpnext gitlab marketing observability demo-stackoverflow; do
  rdc term connect "$repo@hostinger" -c 'for c in $(docker ps --format "{{.Names}}"); do
    echo "$c: $(docker exec "$c" sh -c "nginx -v 2>&1; php -v 2>/dev/null | head -1")"
  done'
done
rdc term connect <repo> ouvre un shell dans l’environnement propre au dépôt, avec DOCKER_HOST qui pointe déjà vers le démon Docker de ce dépôt. Une seule boucle a couvert toute la machine.
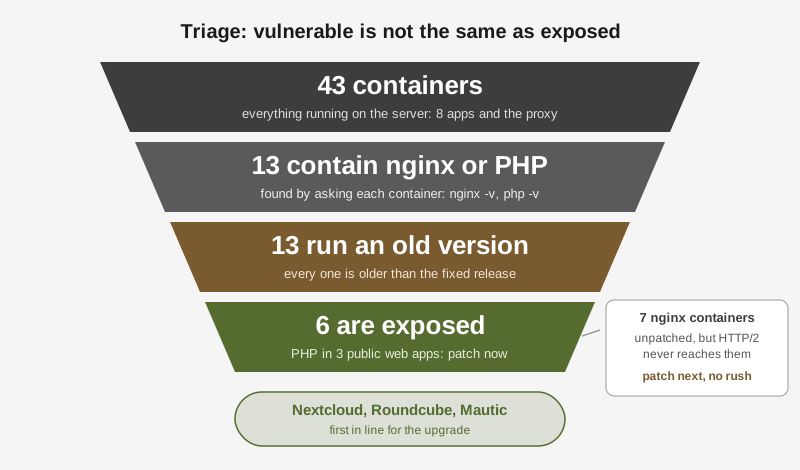
Résultat : 13 conteneurs contenaient nginx ou PHP, et les 13 étaient plus anciens que le correctif. Cela ressemble à 13 urgences. Ce n’en était pas.
Vulnérable veut dire que le code contient le bug. Exposé veut dire qu’un attaquant peut réellement l’atteindre. La différence tient au chemin réseau, et sur ce serveur toutes les requêtes publiques passent par le même.
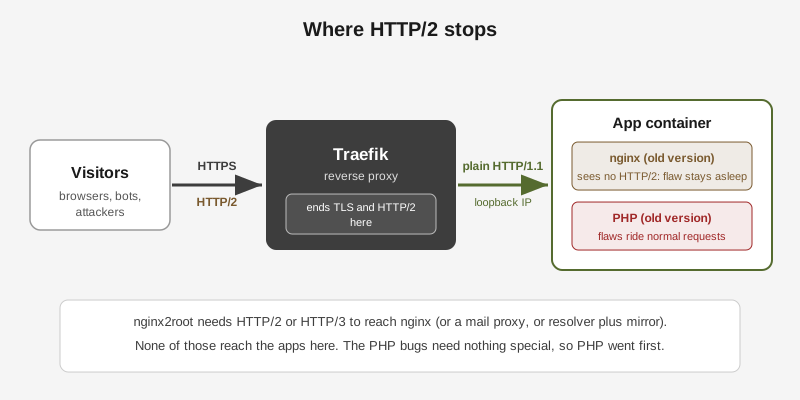
Traefik, le reverse proxy placé devant chaque dépôt, termine le TLS et le HTTP/2. Il parle à chaque application en HTTP/1.1 en clair, sur une adresse loopback privée. Nous avons vérifié les configs nginx des deux applications qui embarquent nginx : pas de http2, pas de HTTP/3, pas de mirror, pas de proxy mail. nginx2root n’avait donc aucune porte d’entrée.
Les bugs PHP, eux, sont différents. Ils passent dans des requêtes web ordinaires. Nextcloud, Roundcube (le webmail) et Mautic tournaient tous sur PHP derrière Apache, étaient tous accessibles depuis Internet, et avaient tous une version de correctif de retard. Ces six conteneurs sont passés en premier.
Un détail arrangeait un peu le tableau côté PHP : les trois applications exécutent PHP comme module Apache, pas avec PHP-FPM, donc les bugs réservés à FPM ne s’appliquaient pas. Ceux des sessions et des fuseaux horaires, si.
Étape 2 : trouver le correctif officiel, et faire confiance au registre plutôt qu’aux articles
Nos premières recherches web ont renvoyé des réponses assurées, mais contradictoires. Un article disait que l’image officielle de Nextcloud embarquait encore un ancien PHP. Un autre affirmait qu’une image tierce avait le correctif. Aucun ne citait l’image elle-même.
Pas besoin de télécharger une image pour lire son contenu. Le registre expose la config de chaque image, et les images officielles basées sur PHP y notent PHP_VERSION.
curl -s "https://registry-1.docker.io/v2/library/nextcloud/blobs/<config-digest>" \
  -H "Authorization: Bearer $TOKEN" | jq -r '.config.Env[]' | grep PHP_VERSION
# PHP_VERSION=8.5.13
Cela nous a donné une réponse claire pour chaque application en quelques minutes :
| Application | En production | Correctif officiel | PHP dans le correctif |
|---|---|---|---|
| Nextcloud | 35.0.2 | nextcloud:35.0.3-apache | 8.5.13 |
| Roundcube | 1.7.5 | roundcube/roundcubemail:1.7.6-apache | 8.4.28 |
| Mautic | 7.2.1 | mautic/mautic:7.2.2-20261119-apache | 8.3.37 |
| ERPNext | v16.52.1 | frappe/erpnext:v16.60.0 | (nginx : inconnu) |
ERPNext était le cas à part. Son nginx vient du paquet Debian, donc la chaîne de version reste à 1.26.3 dans les deux cas. Le build corrigé de Debian est 1.26.3-3+deb13u11, publié le 19 novembre. La nouvelle image d’ERPNext a été construite le soir même. Le correctif y était-il ? La config de l’image ne peut pas le dire. Seul le lancement de l’image le peut.
Étape 3 : répéter la mise à jour risquée sur un fork
Les versions de correctif comme Roundcube 1.7.5 vers 1.7.6 sont peu risquées. ERPNext v16.52 vers v16.60, c’est huit versions de migrations de base de données sur de vraies données comptables. Celle-là a eu droit à une répétition.
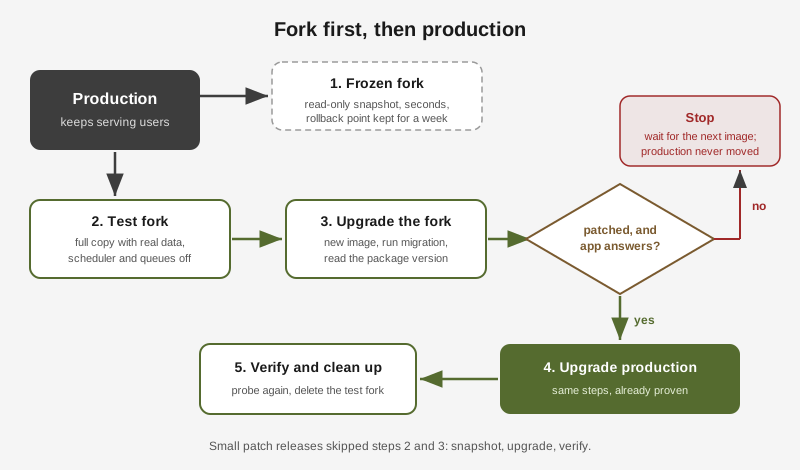
Un fork Rediacc est une copie complète d’un dépôt, données comprises, faite avec un clone copy-on-write. Il prend quelques secondes quelle que soit la taille, et la copie reçoit son propre démon Docker, sa propre plage d’IP et sa propre URL. Rien de ce qu’elle contient ne peut toucher la production.
rdc repo fork erpnext@hostinger --tag cve-test
rdc repo up erpnext:cve-test@hostinger --no-start   # mount only, start nothing yet
Avant de démarrer le fork, nous avons modifié son fichier compose : le nouveau tag d’image, et le scheduler ainsi que les deux files de jobs mis de côté dans un profil désactivé. Une copie de vraies données ERPNext avec un scheduler actif enverrait de vrais e-mails à de vrais clients. Avec ces services coupés, le fork pouvait servir des pages et lancer des migrations, rien de plus.
docker run --rm --entrypoint dpkg-query frappe/erpnext:v16.60.0 -W nginx
# nginx  1.26.3-3+deb13u11
Voilà la réponse : la nouvelle image embarquait le nginx corrigé de Debian. Ensuite, le fork a déroulé la mise à jour complète : bench --site all migrate s’est terminé proprement sur une copie de la base de production, l’application a répondu pong sur son endpoint de santé, et la page de connexion s’est affichée sur l’URL propre du fork.
Si l’image avait encore contenu l’ancien paquet, le plan était simple : tout arrêter, supprimer le fork et attendre le build suivant. La production serait restée intacte, au lieu de redémarrer pour une mise à jour qui ne corrigeait rien.
Étape 4 : la production, une application à la fois
Chaque application a suivi la même routine courte :
- Snapshot.
rdc repo fork <app> --tag pre-cve-20261120 --immutablecrée une copie figée, en lecture seule. Elle ne peut être ni montée ni démarrée, donc rien ne peut jamais la modifier. - Épingler le tag. Modifier le fichier compose avec le tag corrigé exact.
- Pull, puis déploiement.
docker pull, puisrdc repo up <app> -y. - Lancer l’étape de mise à jour propre à l’application quand elle en a une.
- Vérifier de l’intérieur (version, migrations) et de l’extérieur (l’URL publique).
| Application | Ce qui s’est passé | Conteneurs de nouveau en ligne |
|---|---|---|
| Nextcloud | L’entrypoint de l’image a lancé occ upgrade 35.0.2 vers 35.0.3, environ une minute en mode maintenance | 66 s |
| Roundcube | Simple remplacement d’image, la vérification du schéma n’a rien trouvé à faire | 24 s |
| Mautic | Disque plein au premier pull (voir plus bas), puis doctrine:migrations:migrate | 6 s |
| ERPNext | Mêmes étapes que la répétition, scheduler laissé actif, bench migrate avec un code de sortie 0 | 17 s |
La sonde finale a montré PHP 8.5.13, 8.4.28 et 8.3.37 dans chaque conteneur PHP, nginx deb13u11 dans ERPNext, et les 43 conteneurs en marche, sans aucun health check en échec.
Ce qui s’est mal passé
Un tag flottant cachait une image périmée. Nextcloud utilisait nextcloud:35-apache. Ce tag pointait déjà vers l’image corrigée, mais docker compose up -d ne télécharge pas une image qu’il a déjà, et le serveur aurait donc gardé l’ancien PHP indéfiniment. Épingler 35.0.3-apache rend la version en cours visible dans le fichier compose et force un vrai changement à chaque mise à jour.
Un disque s’est rempli en plein téléchargement. L’image Mautic pèse 2,1 Go, et son dépôt avait 1,4 Go de libre. Le pull a échoué avec no space left on device avant de toucher aux conteneurs en cours d’exécution. La solution tenait en une commande, lancée alors que Mautic continuait de servir du trafic :
rdc repo expand mautic@hostinger --size 12G
# Repository expanded (3.9s)
Le volume est passé de 8 Go à 12 Go à chaud, et le pull a abouti. La politique de taille de la machine peut désormais agrandir un dépôt automatiquement avant qu’il ne se remplisse.
Les snapshots figés n’ont jamais servi. Toutes les mises à jour ont fonctionné, donc les quatre copies pre-cve sont restées là sans rien faire. C’est le principe d’un filet de sécurité, mais deux remarques honnêtes. Elles ont été prises pendant que les applications tournaient, donc les fichiers de base de données qu’elles contiennent sont cohérents après crash, dans le même état qu’après une coupure de courant, et non après un arrêt propre. Et un rollback jamais répété est un plan, pas une garantie. La prochaine fois, nous testerons une restauration tant que le snapshot est encore frais.
Une application n’a pas encore de version corrigée. Une deuxième application embarque son propre nginx dans l’image de l’éditeur, et cet éditeur n’a pas encore publié nginx 1.31.9. Le chemin du trafic décrit plus haut tient HTTP/2 à l’écart, donc elle attend la version de l’éditeur plutôt qu’une image construite à la main.
Les choix, et pourquoi
| Option envisagée | Ce que nous avons choisi | Pourquoi |
|---|---|---|
| Désactiver HTTP/2 comme mitigation rapide | Patcher avec de nouvelles images | HTTP/2 s’arrêtait déjà à Traefik, la mitigation n’apportait donc rien. Patcher supprime le bug au lieu de le cacher. |
| Se fier à la chaîne de version | Vérifier le paquet dans l’image | Debian rétroporte les correctifs sans changer nginx -v. Seul dpkg-query montre le vrai build. |
| Croire les articles sur l’image corrigée | Lire la config de l’image dans le registre | Les articles se contredisaient. Le registre est la source. |
Tags flottants comme 35-apache | Tags exacts comme 35.0.3-apache | Un tag flottant peut pointer vers le correctif pendant que le serveur continue d’exécuter l’ancienne image. |
| Mettre à jour sur place, rollback en cas de casse | Fork d’abord pour les gros sauts, snapshot d’abord pour les petits | Une répétition sur un fork coûte quelques secondes et trouve le problème avant les utilisateurs. Une répétition complète pour une version de correctif d’un seul cran est excessive. |
Répartir le trafic avec un canary (rdc repo canary) | Répéter sur un fork | Un canary exécute la nouvelle version sur les données réelles, ce qui convient aux applications dont les schémas sont rétrocompatibles. Une migration de 8 versions n’en fait pas partie. |
| Nettoyer le disque plein à la main | Agrandir le volume à chaud | Supprimer des fichiers dans le dossier de données de Docker est risqué. Agrandir tient en une commande et ne demande aucun redémarrage. |
La checklist que nous gardons
- Demander à chaque conteneur ce qu’il exécute. Ne pas lire les tags.
- Séparer vulnérable et exposé en suivant le vrai chemin réseau.
- Patcher les exposés aujourd’hui, le reste cette semaine.
- Lire le correctif dans le registre, pas dans les articles.
- Pour un correctif livré par paquet, vérifier le build du paquet dans l’image.
- Faire un snapshot avant chaque changement. Répéter sur un fork quand la mise à jour migre des données.
- Épingler des tags exacts.
- Vérifier de l’intérieur et de l’extérieur, puis nettoyer les forks.
L’ensemble de l’opération, de la lecture des avis de sécurité à la dernière vérification, a été piloté par un agent IA (Claude Code) travaillant via rdc, avec un accès à la production accordé par l’opérateur avant le début de la session. C’est la routine fork d’abord qui a rendu cela confortable : l’agent faisait ses expériences sur des copies, et la production ne voyait que des étapes qui avaient déjà fonctionné.