Resumen. nginx publicó los arreglos para nginx2root (CVE-2026-123007 y otros cuatro RCE hermanos) el 18 de noviembre. PHP publicó arreglos para 17 CVE, siete de ellos críticos, el 19 de noviembre. En la tarde del 20 parcheamos nuestro propio servidor de producción.
- 43 contenedores revisados en minutos, preguntándole a cada uno qué versión de nginx y PHP ejecuta.
- 13 corrían una versión vieja. Solo 6 estaban expuestos: los contenedores PHP de tres aplicaciones web públicas.
- Cada arreglo vino de una imagen oficial, verificada en el registry antes de descargarla.
- La actualización más riesgosa (un salto de 8 releases de ERPNext) se ensayó antes en un fork con datos reales. El fork respondió la única pregunta que las notas de la release no podían responder.
- Un disco se llenó a mitad de una descarga. Ampliar el volumen en caliente tomó 3,9 segundos, sin downtime.
Qué se divulgó
nginx2root es un conjunto de cinco bugs de ejecución remota de código en nginx de código abierto. El principal, CVE-2026-123007, es un integer underflow en el control de flujo de HTTP/2, con puntuación 9,2 en CVSS 4.0. Afecta a todas las versiones de nginx desde la 1.9.5 (2015) hasta la 1.31.8 que tengan HTTP/2 activado. Los otros cuatro requieren HTTP/3 detrás de un proxy, el proxy de correo con auth_http, o el resolver DNS usado junto con mirror. Versiones corregidas: 1.31.9 (mainline) y 1.30.7 (stable). Ese mismo día apareció una prueba de concepto pública.
La release de PHP llegó un día después: 8.5.13, 8.4.28, 8.3.37 y 8.2.36. Los peores bugs están en el manejo de sesiones y en la caché de zonas horarias, y pueden terminar en ejecución de código. Un segundo grupo afecta solo a PHP-FPM: request smuggling, un XSS en la página de estado y una escalada de privilegios local.
El servidor de esta historia es hostinger, la misma máquina de producción de nuestra prueba de PocketOS. Ejecuta un servidor de correo con webmail, Nextcloud, un stack de marketing, ERPNext, un GitLab, un stack de observabilidad y algunas demos. Cada aplicación vive en su propio repositorio de Rediacc: un volumen cifrado con su propio daemon de Docker y su propio rango de IP privadas.
Paso 1: encontrar qué es vulnerable y luego qué está expuesto
Los tags de las imágenes mienten por omisión. nextcloud:35-apache no dice nada del PHP que lleva dentro, y un paquete de Debian sigue mostrando nginx/1.26.3 antes y después de un arreglo de seguridad. Así que, en vez de leer tags, le preguntamos directamente a cada contenedor en ejecución.
for repo in nextcloud mail mautic erpnext gitlab marketing observability demo-stackoverflow; do
  rdc term connect "$repo@hostinger" -c 'for c in $(docker ps --format "{{.Names}}"); do
    echo "$c: $(docker exec "$c" sh -c "nginx -v 2>&1; php -v 2>/dev/null | head -1")"
  done'
done
rdc term connect <repo> abre una shell dentro del entorno propio del repositorio, con DOCKER_HOST ya apuntando al daemon de Docker de ese repositorio. Un solo bucle cubrió toda la máquina.
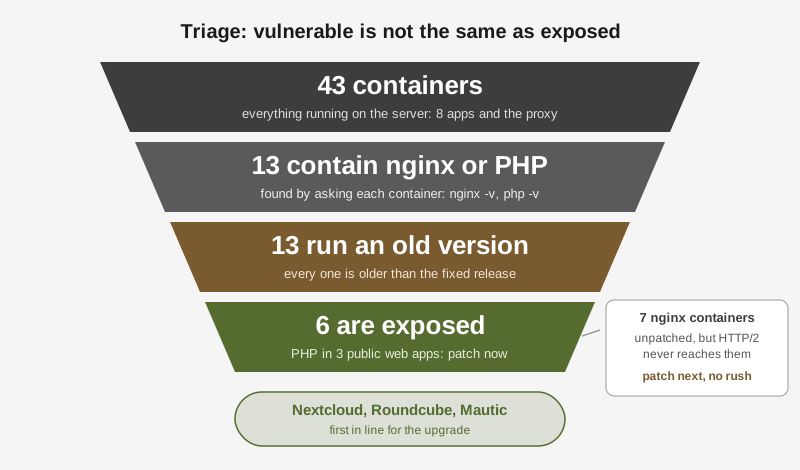
El resultado: 13 contenedores tenían nginx o PHP, y los 13 eran anteriores al arreglo. Suena a 13 emergencias. No lo era.
Vulnerable significa que el código tiene el bug. Expuesto significa que un atacante realmente puede llegar al bug. La diferencia es la ruta de red, y en este servidor todas las peticiones públicas siguen la misma ruta.
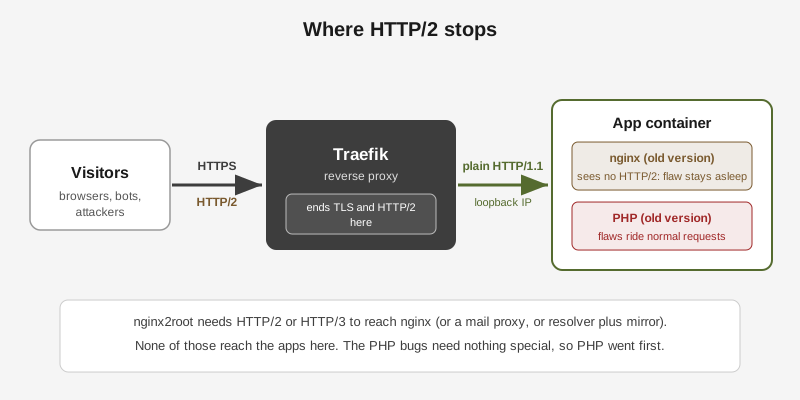
Traefik, el proxy inverso que está delante de todos los repositorios, termina TLS y HTTP/2. Habla con cada aplicación por HTTP/1.1 plano en una dirección loopback privada. Revisamos las configuraciones de nginx dentro de las dos aplicaciones que traen nginx incluido: sin http2, sin HTTP/3, sin mirror, sin proxy de correo. Así que nginx2root no tenía por dónde entrar.
Los bugs de PHP son distintos. Viajan dentro de peticiones web normales. Nextcloud, Roundcube (el webmail) y Mautic corrían PHP detrás de Apache, todos daban a internet y todos estaban una patch release atrás. Esos seis contenedores pasaron al principio de la fila.
Un detalle mejoraba un poco el panorama de PHP: las tres aplicaciones ejecutan PHP como módulo de Apache, no como PHP-FPM, así que los bugs exclusivos de FPM no aplicaban. Los de sesiones y zonas horarias sí.
Paso 2: encontrar el arreglo oficial y confiar en el registry antes que en los blogs
Nuestras primeras búsquedas web devolvieron respuestas seguras y contradictorias. Un artículo decía que la imagen oficial de Nextcloud seguía trayendo un PHP viejo. Otro decía que una imagen de terceros tenía el arreglo. Ninguno citaba la imagen en sí.
No hace falta descargar la imagen para leer lo que lleva dentro. El registry sirve la configuración de cada imagen, y las imágenes oficiales basadas en PHP guardan PHP_VERSION ahí.
curl -s "https://registry-1.docker.io/v2/library/nextcloud/blobs/<config-digest>" \
  -H "Authorization: Bearer $TOKEN" | jq -r '.config.Env[]' | grep PHP_VERSION
# PHP_VERSION=8.5.13
Eso nos dio una respuesta clara para cada aplicación en pocos minutos:
| App | En ejecución | Arreglo oficial | PHP dentro del arreglo |
|---|---|---|---|
| Nextcloud | 35.0.2 | nextcloud:35.0.3-apache | 8.5.13 |
| Roundcube | 1.7.5 | roundcube/roundcubemail:1.7.6-apache | 8.4.28 |
| Mautic | 7.2.1 | mautic/mautic:7.2.2-20261119-apache | 8.3.37 |
| ERPNext | v16.52.1 | frappe/erpnext:v16.60.0 | (nginx: desconocido) |
ERPNext era el caso raro. Su nginx viene del paquete de Debian, así que la cadena de versión sigue en 1.26.3 en ambos casos. El build corregido de Debian es 1.26.3-3+deb13u11, publicado el 19 de noviembre. La nueva imagen de ERPNext se construyó esa tarde. ¿Traía el arreglo? La configuración de la imagen no lo dice. Solo ejecutarla lo dice.
Paso 3: ensayar en un fork lo que más riesgo tiene
Las patch releases como Roundcube 1.7.5 a 1.7.6 tienen poco riesgo. ERPNext v16.52 a v16.60 son ocho releases de migraciones de base de datos sobre datos contables reales. Esa sí merecía un ensayo.
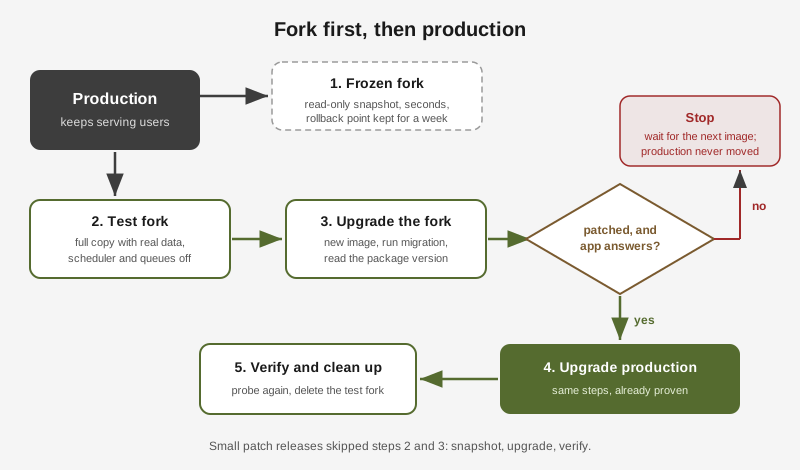
Un fork de Rediacc es una copia completa de un repositorio, con sus datos, hecha con un clon copy-on-write. Toma segundos sin importar el tamaño, y la copia recibe su propio daemon de Docker, rango de IP y URL. Nada de lo que pase ahí puede tocar producción.
rdc repo fork erpnext@hostinger --tag cve-test
rdc repo up erpnext:cve-test@hostinger --no-start   # mount only, start nothing yet
Antes de arrancar el fork, editamos su archivo compose: el nuevo tag de la imagen, y el scheduler y las dos colas de jobs aparcados bajo un profile desactivado. Una copia de datos reales de ERPNext con el scheduler corriendo enviaría correos reales a clientes reales. Con eso apagado, el fork podía servir páginas y ejecutar migraciones, y nada más.
docker run --rm --entrypoint dpkg-query frappe/erpnext:v16.60.0 -W nginx
# nginx  1.26.3-3+deb13u11
Ahí estaba la respuesta: la nueva imagen traía el nginx parcheado de Debian. Luego el fork ejecutó la actualización completa: bench --site all migrate terminó sin errores sobre una copia de la base de datos de producción, la aplicación respondió pong en su endpoint de salud, y la página de login cargó en la URL propia del fork.
Si la imagen hubiera seguido con el paquete viejo, el plan era simple: parar, borrar el fork y esperar al siguiente build. Producción habría quedado intacta, en vez de reiniciarse por una actualización que no arreglaba nada.
Paso 4: producción, una aplicación a la vez
Cada aplicación siguió la misma rutina corta:
- Snapshot.
rdc repo fork <app> --tag pre-cve-20261120 --immutablecrea una copia congelada de solo lectura. No se puede montar ni arrancar, así que nada puede cambiarla. - Fijar el tag. Editar el archivo compose con el tag exacto del arreglo.
- Pull y luego deploy.
docker pull, y despuésrdc repo up <app> -y. - Ejecutar el paso de actualización propio de la aplicación cuando lo tenga.
- Verificar desde dentro (versión, migraciones) y desde fuera (la URL pública).
| App | Qué pasó | Contenedores de vuelta |
|---|---|---|
| Nextcloud | El entrypoint de la imagen ejecutó occ upgrade 35.0.2 a 35.0.3, cerca de un minuto en modo mantenimiento | 66 s |
| Roundcube | Cambio de imagen simple, la revisión del esquema no encontró nada que hacer | 24 s |
| Mautic | Disco lleno en el primer pull (más abajo), luego doctrine:migrations:migrate | 6 s |
| ERPNext | Los mismos pasos del ensayo, scheduler encendido, bench migrate con código de salida 0 | 17 s |
La sonda final mostró PHP 8.5.13, 8.4.28 y 8.3.37 en cada contenedor PHP, nginx deb13u11 en ERPNext, y los 43 contenedores en marcha sin ningún health check fallando.
Qué salió mal
Un tag flotante escondía una imagen vieja. Nextcloud estaba en nextcloud:35-apache. Ese tag ya apuntaba a la imagen corregida, pero docker compose up -d no descarga una imagen que ya tiene, así que el servidor habría seguido con el PHP viejo para siempre. Fijar 35.0.3-apache deja la versión en ejecución visible en el archivo compose y fuerza un cambio real en cada actualización.
Un disco se llenó a mitad de la descarga. La imagen de Mautic pesa 2,1 GB, y su repositorio tenía 1,4 GB libres. El pull falló con no space left on device antes de tocar los contenedores en ejecución. El arreglo fue un solo comando, con Mautic todavía sirviendo tráfico:
rdc repo expand mautic@hostinger --size 12G
# Repository expanded (3.9s)
El volumen pasó de 8 GB a 12 GB en caliente, y el pull terminó bien. La política de tamaño de la máquina ahora puede ampliar un repositorio automáticamente antes de que se llene.
Los snapshots congelados nunca se usaron. Todas las actualizaciones funcionaron, así que las cuatro copias pre-cve se quedaron ahí sin usarse. Para eso sirve una red de seguridad, pero con dos notas honestas. Se tomaron con las aplicaciones en marcha, así que los archivos de base de datos que contienen son crash-consistent, el mismo estado que tras un corte de luz, no el de un apagado limpio. Y un rollback que nunca se ha ensayado es un plan, no una garantía. La próxima vez probaremos una restauración mientras el snapshot siga fresco.
Una aplicación todavía no tiene release corregida. Otra aplicación trae su propio nginx dentro de la imagen del proveedor, y ese proveedor aún no ha publicado nginx 1.31.9. La ruta de tráfico de arriba mantiene HTTP/2 lejos de ella, así que esperará la release del proveedor en vez de una imagen armada a mano.
Las decisiones y por qué
| Opción que teníamos | Lo que elegimos | Por qué |
|---|---|---|
| Desactivar HTTP/2 como mitigación rápida | Parchear con imágenes nuevas | HTTP/2 ya se terminaba en Traefik, así que la mitigación no aportaba nada. Parchear elimina el bug en vez de esconderlo. |
| Confiar en la cadena de versión | Revisar el paquete dentro de la imagen | Debian hace backport de arreglos sin cambiar nginx -v. Solo dpkg-query muestra el build real. |
| Confiar en artículos sobre qué imagen está corregida | Leer la configuración de la imagen en el registry | Los artículos no coincidían. El registry es la fuente. |
Tags flotantes como 35-apache | Tags exactos como 35.0.3-apache | Un tag flotante puede apuntar al arreglo mientras el servidor sigue con la imagen vieja. |
| Actualizar en el lugar y hacer rollback si falla | Fork primero para saltos grandes, snapshot primero para los pequeños | Ensayar en un fork cuesta segundos y encuentra el problema antes que los usuarios. Un ensayo completo para una patch release de un solo paso es excesivo. |
Dividir el tráfico con un canary (rdc repo canary) | Ensayar en un fork | Un canary ejecuta la versión nueva sobre datos en vivo, lo que sirve para aplicaciones con esquemas retrocompatibles. Una migración de 8 releases no es el caso. |
| Limpiar el disco lleno a mano | Ampliar el volumen en caliente | Borrar archivos dentro de la carpeta de datos de Docker es arriesgado. Ampliar es un comando y no requiere reinicio. |
La checklist que conservamos
- Preguntarle a cada contenedor qué ejecuta. No leer tags.
- Separar lo vulnerable de lo expuesto siguiendo la ruta de red real.
- Parchear hoy lo expuesto, y el resto esta semana.
- Leer el arreglo del registry, no de artículos.
- Para un arreglo basado en paquete, revisar el build del paquete dentro de la imagen.
- Hacer un snapshot antes de cada cambio. Ensayar en un fork cuando la actualización migra datos.
- Fijar tags exactos.
- Verificar desde dentro y desde fuera, y luego limpiar los forks.
Todo el proceso, desde leer los avisos hasta la última verificación, lo condujo un agente de IA (Claude Code) trabajando con rdc, con acceso a producción concedido por el operador antes de empezar la sesión. La rutina de fork primero es lo que lo hizo cómodo: el agente hizo sus experimentos en copias, y producción solo vio pasos que ya habían funcionado.