Resumo. O nginx publicou correções para o nginx2root (CVE-2026-123007 e mais quatro RCEs relacionadas) a 18 de novembro. O PHP publicou correções para 17 CVEs, sete delas críticas, a 19 de novembro. Na noite do dia 20 corrigimos o nosso próprio servidor de produção.
- 43 contentores verificados em minutos, perguntando a cada um qual nginx e qual PHP executa.
- 13 usavam uma versão antiga. Apenas 6 estavam expostos: os contentores PHP de três aplicações web públicas.
- Cada correção veio de uma imagem oficial, confirmada no registry antes do download.
- A atualização mais arriscada (um salto de 8 versões do ERPNext) foi ensaiada antes num fork com dados reais. O fork respondeu à única pergunta que as notas de versão não conseguiam responder.
- Um disco encheu a meio de um download. Aumentar o volume online demorou 3,9 segundos, sem downtime.
O que foi divulgado
O nginx2root é um conjunto de cinco falhas de execução remota de código no nginx de código aberto. A principal, CVE-2026-123007, é um integer underflow no controlo de fluxo do HTTP/2, com pontuação 9,2 no CVSS 4.0. Afeta todos os nginx de 1.9.5 (2015) a 1.31.8 que tenham o HTTP/2 ativado. As outras quatro exigem HTTP/3 atrás de um proxy, o proxy de correio com auth_http, ou o resolvedor de DNS usado em conjunto com mirror. Versões corrigidas: 1.31.9 (mainline) e 1.30.7 (stable). Uma prova de conceito pública apareceu no mesmo dia.
A versão do PHP chegou um dia depois: 8.5.13, 8.4.28, 8.3.37 e 8.2.36. As piores falhas estão na gestão de sessões e na cache de fusos horários, e podem terminar em execução de código. Um segundo grupo afeta apenas o PHP-FPM: request smuggling, um XSS na página de estado e uma escalada de privilégios local.
O servidor desta história é o hostinger, a mesma máquina de produção do nosso teste do PocketOS. Corre um servidor de correio com webmail, Nextcloud, uma stack de marketing, ERPNext, um GitLab, uma stack de observabilidade e algumas demos. Cada aplicação vive no seu próprio repositório Rediacc: um volume cifrado com o seu próprio daemon Docker e a sua própria gama de IPs privados.
Passo 1: descobrir o que é vulnerável e depois o que está exposto
As tags de imagem mentem por omissão. nextcloud:35-apache não diz nada sobre o PHP lá dentro, e um pacote Debian continua a reportar nginx/1.26.3 antes e depois de uma correção de segurança. Por isso, em vez de ler tags, perguntámos diretamente a cada contentor em execução.
for repo in nextcloud mail mautic erpnext gitlab marketing observability demo-stackoverflow; do
  rdc term connect "$repo@hostinger" -c 'for c in $(docker ps --format "{{.Names}}"); do
    echo "$c: $(docker exec "$c" sh -c "nginx -v 2>&1; php -v 2>/dev/null | head -1")"
  done'
done
rdc term connect <repo> abre uma shell dentro do ambiente do próprio repositório, com DOCKER_HOST já apontado para o daemon Docker desse repositório. Um só loop cobriu a máquina inteira.
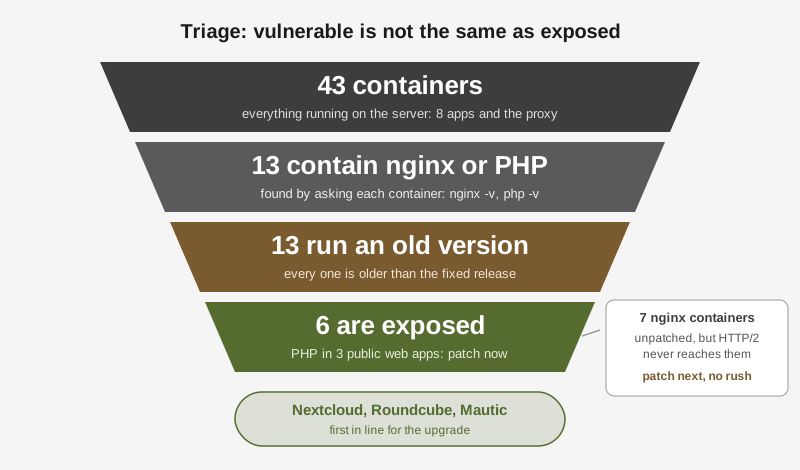
O resultado: 13 contentores tinham nginx ou PHP, e todos os 13 estavam atrás da correção. Parece 13 emergências. Não era.
Vulnerável quer dizer que o código tem a falha. Exposto quer dizer que um atacante consegue mesmo chegar a ela. A diferença é o caminho de rede, e neste servidor todos os pedidos públicos seguem o mesmo caminho.
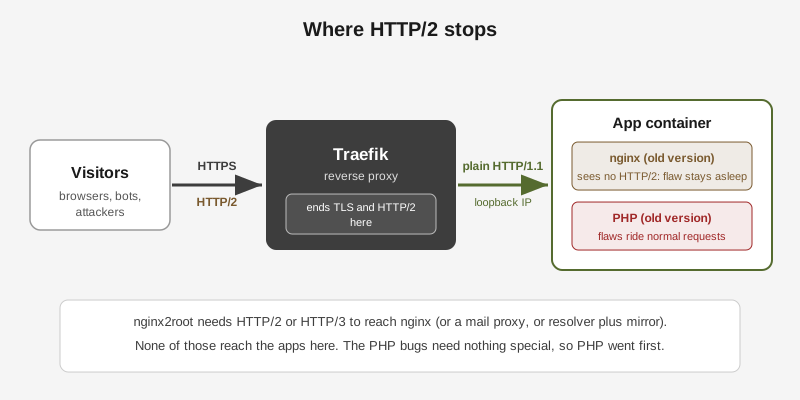
O Traefik, o proxy reverso à frente de todos os repositórios, termina o TLS e o HTTP/2. Fala com cada aplicação em HTTP/1.1 simples, num endereço loopback privado. Verificámos as configurações do nginx dentro das duas aplicações que trazem nginx incluído: sem http2, sem HTTP/3, sem mirror, sem proxy de correio. Portanto o nginx2root não tinha por onde entrar.
As falhas do PHP são diferentes. Viajam dentro de pedidos web normais. O Nextcloud, o Roundcube (o webmail) e o Mautic corriam PHP atrás do Apache, todos davam para a internet, e todos estavam uma versão de correção atrasados. Esses seis contentores passaram para o início da fila.
Um detalhe melhorava um pouco o quadro do PHP: as três aplicações correm o PHP como módulo do Apache, não como PHP-FPM, por isso as falhas exclusivas do FPM não se aplicavam. As falhas de sessão e de fuso horário continuavam a aplicar-se.
Passo 2: encontrar a correção oficial e confiar mais no registry do que em artigos
As nossas primeiras pesquisas na web devolveram respostas confiantes e contraditórias. Um artigo dizia que a imagem oficial do Nextcloud ainda trazia um PHP antigo. Outro dizia que uma imagem de terceiros tinha a correção. Nenhum citava a imagem em si.
Não é preciso descarregar a imagem para ver o que ela contém. O registry serve a configuração de cada imagem, e as imagens oficiais baseadas em PHP registam aí o PHP_VERSION.
curl -s "https://registry-1.docker.io/v2/library/nextcloud/blobs/<config-digest>" \
  -H "Authorization: Bearer $TOKEN" | jq -r '.config.Env[]' | grep PHP_VERSION
# PHP_VERSION=8.5.13
Isso deu uma resposta clara para cada aplicação em poucos minutos:
| Aplicação | Em execução | Correção oficial | PHP dentro da correção |
|---|---|---|---|
| Nextcloud | 35.0.2 | nextcloud:35.0.3-apache | 8.5.13 |
| Roundcube | 1.7.5 | roundcube/roundcubemail:1.7.6-apache | 8.4.28 |
| Mautic | 7.2.1 | mautic/mautic:7.2.2-20261119-apache | 8.3.37 |
| ERPNext | v16.52.1 | frappe/erpnext:v16.60.0 | (nginx: desconhecido) |
O ERPNext era o caso estranho. O nginx dele vem do pacote do Debian, por isso a string de versão fica em 1.26.3 de qualquer forma. A build corrigida do Debian é 1.26.3-3+deb13u11, publicada a 19 de novembro. A nova imagem do ERPNext foi construída nessa noite. A correção estava lá dentro? A configuração da imagem não consegue dizer. Só executar a imagem diz.
Passo 3: ensaiar a atualização arriscada num fork
Versões de correção como o Roundcube 1.7.5 para 1.7.6 têm risco baixo. O ERPNext v16.52 para v16.60 são oito versões de migrações de base de dados sobre dados contabilísticos reais. Essa mereceu um ensaio.
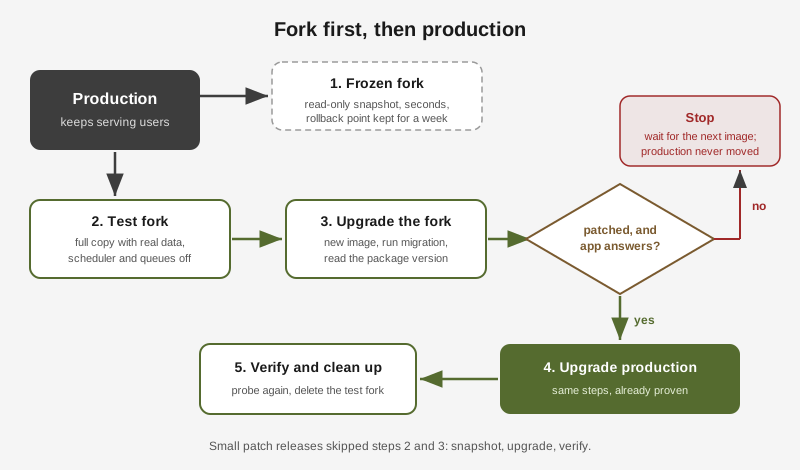
Um fork do Rediacc é uma cópia completa de um repositório, dados incluídos, feita com um clone copy-on-write. Demora segundos, qualquer que seja o tamanho, e a cópia ganha o seu próprio daemon Docker, gama de IPs e URL. Nada nela pode tocar na produção.
rdc repo fork erpnext@hostinger --tag cve-test
rdc repo up erpnext:cve-test@hostinger --no-start   # mount only, start nothing yet
Antes de arrancar o fork, editámos o ficheiro compose: a nova tag de imagem, e o scheduler e as duas filas de jobs postos de parte num profile desativado. Uma cópia de dados reais do ERPNext com o scheduler a correr enviaria emails reais a clientes reais. Com isso desligado, o fork podia servir páginas e executar migrações, e mais nada.
docker run --rm --entrypoint dpkg-query frappe/erpnext:v16.60.0 -W nginx
# nginx  1.26.3-3+deb13u11
Aí estava a resposta: a nova imagem trazia o nginx corrigido do Debian. Depois o fork correu a atualização completa: o bench --site all migrate terminou sem erros numa cópia da base de dados de produção, a aplicação respondeu pong no endpoint de health, e a página de login carregou no URL do próprio fork.
Se a imagem ainda trouxesse o pacote antigo, o plano era simples: parar, apagar o fork e esperar pela build seguinte. A produção teria ficado intocada, em vez de reiniciar por uma atualização que não corrigia nada.
Passo 4: produção, uma aplicação de cada vez
Cada aplicação seguiu a mesma rotina curta:
- Snapshot.
rdc repo fork <app> --tag pre-cve-20261120 --immutablecria uma cópia congelada, só de leitura. Não pode ser montada nem iniciada, por isso nada a pode alterar. - Fixar a tag. Editar o ficheiro compose para a tag exata corrigida.
- Pull e depois deploy.
docker pull, depoisrdc repo up <app> -y. - Executar o passo de atualização da própria aplicação, quando existe.
- Verificar por dentro (versão, migrações) e por fora (o URL público).
| Aplicação | O que aconteceu | Contentores de volta |
|---|---|---|
| Nextcloud | O entrypoint da imagem executou occ upgrade 35.0.2 para 35.0.3, cerca de um minuto em modo de manutenção | 66 s |
| Roundcube | Troca simples de imagem, a verificação do schema não encontrou nada a fazer | 24 s |
| Mautic | Disco cheio no primeiro pull (abaixo), depois doctrine:migrations:migrate | 6 s |
| ERPNext | Os mesmos passos do ensaio, scheduler mantido ligado, bench migrate com código de saída 0 | 17 s |
A sonda final mostrou PHP 8.5.13, 8.4.28 e 8.3.37 em todos os contentores PHP, nginx deb13u11 no ERPNext, e os 43 contentores a correr sem nenhuma verificação de health a falhar.
O que correu mal
Uma tag flutuante escondeu uma imagem desatualizada. O Nextcloud estava em nextcloud:35-apache. Essa tag já apontava para a imagem corrigida, mas o docker compose up -d não faz pull de uma imagem que já existe localmente, por isso o servidor ficaria com o PHP antigo para sempre. Fixar 35.0.3-apache torna a versão em execução visível no ficheiro compose e força uma mudança real em cada atualização.
Um disco encheu a meio de um download. A imagem do Mautic tem 2,1 GB, e o repositório tinha 1,4 GB livres. O pull falhou com no space left on device antes de mexer nos contentores em execução. A solução foi um comando, feito com o Mautic ainda a servir tráfego:
rdc repo expand mautic@hostinger --size 12G
# Repository expanded (3.9s)
O volume cresceu de 8 GB para 12 GB online, e o pull passou. A política de tamanho da máquina agora pode aumentar um repositório automaticamente antes de ele encher.
Os snapshots congelados nunca foram usados. Todas as atualizações funcionaram, por isso as quatro cópias pre-cve ficaram paradas. É esse o objetivo de uma rede de segurança, mas com duas notas honestas. Foram tiradas com as aplicações em execução, por isso os ficheiros de base de dados lá dentro estão consistentes após crash, o mesmo estado de depois de um corte de energia, e não de um encerramento limpo. E um rollback que nunca foi ensaiado é um plano, não uma garantia. Da próxima vez, testamos um restore enquanto o snapshot ainda está fresco.
Uma aplicação ainda não tem versão corrigida. Uma segunda aplicação traz o seu próprio nginx dentro da imagem do fornecedor, e esse fornecedor ainda não publicou o nginx 1.31.9. O caminho do tráfego descrito acima mantém o HTTP/2 longe dela, por isso espera pela versão do fornecedor em vez de uma imagem construída à mão.
As escolhas e porquê
| Opção que tínhamos | O que escolhemos | Porquê |
|---|---|---|
| Desativar o HTTP/2 como mitigação rápida | Corrigir com imagens novas | O HTTP/2 já acabava no Traefik, por isso a mitigação não acrescentava nada. Corrigir elimina a falha em vez de a esconder. |
| Confiar na string de versão | Verificar o pacote dentro da imagem | O Debian faz backport de correções sem mudar o nginx -v. Só o dpkg-query mostra a build real. |
| Confiar em artigos sobre qual imagem está corrigida | Ler a configuração da imagem no registry | Os artigos discordavam. O registry é a fonte. |
Tags flutuantes como 35-apache | Tags exatas como 35.0.3-apache | Uma tag flutuante pode apontar para a correção enquanto o servidor continua a executar a imagem antiga. |
| Atualizar no local, fazer rollback se quebrar | Fork primeiro para saltos grandes, snapshot primeiro para os pequenos | O ensaio num fork custa segundos e encontra o problema antes dos utilizadores. Um ensaio completo para uma versão de correção de um só passo é exagero. |
Dividir o tráfego com um canary (rdc repo canary) | Ensaiar num fork | Um canary executa a nova versão com dados reais, o que serve para aplicações com schemas retrocompatíveis. Uma migração de 8 versões não é o caso. |
| Limpar o disco cheio à mão | Aumentar o volume online | Apagar ficheiros na pasta de dados do Docker é arriscado. Aumentar é um comando e não precisa de reinício. |
A checklist que mantemos
- Perguntar a cada contentor o que executa. Não ler tags.
- Separar vulnerável de exposto seguindo o caminho de rede real.
- Corrigir os expostos hoje, os restantes esta semana.
- Ler a correção no registry, não em artigos.
- Numa correção baseada em pacote, verificar a build do pacote dentro da imagem.
- Fazer snapshot antes de cada alteração. Ensaiar num fork quando a atualização migra dados.
- Fixar tags exatas.
- Verificar por dentro e por fora, depois limpar os forks.
Todo o processo, desde a leitura dos avisos até à última verificação, foi conduzido por um agente de IA (Claude Code) a trabalhar através do rdc, com acesso à produção concedido pelo operador antes do início da sessão. A rotina de fork primeiro é o que tornou isso confortável: o agente fez as suas experiências em cópias, e a produção só viu passos que já tinham funcionado.